技術入門
ソフトウェア開発におけるAIエージェント適用の現在地と課題:論文から学術的背景を読み解く
NIC ネットワーク制御ソフトウェアプロジェクト
森 優大(もり ゆうだい)
#AI#ソフトウェア開発
2026/3/19
ネットワークイノベーションセンタでは、通信インフラを支えるためのソフトウェア基盤技術の研究開発に取り組んでいます。 その取り組みの中で、ソフトウェア開発にAIエージェントを活用する検討を行っています。
AIエージェントとは、「LLMが自身のプロセスとツールを積極的に制御・判断・実行することで、タスクの解決までを自律的に遂行する」システムを指します[1]
[2] 。
一部では2025年 = AIエージェント元年と称されるほど、AIエージェントは注目を集めました。 NVIDIAのJensen Huang CEOは「従業員5万人に対して1億体のAIアシスタントを配置する」という指針を示し[3] 、 日本国内においても、ソフトバンクグループの孫正義 会長兼社長が「グループ全体で10億体のAIエージェントを活用していく(社員1人あたり1000体)」方針を打ち出しています[4] 。 NTTグループでも、AIエージェント関連のソリューションを提供しています[5] 。
Gartnerが発表した「2025年の戦略的テクノロジトレンド」では「エージェンティックAI(Agentic AI)」がトップに掲げられました[6] 。 ボストン コンサルティング グループ(BCG)の書籍『BCGが読む経営の論点2026』[7] でも主要な経営課題として取り上げられ、多くの紙面が割かれるなど、2026年以降も、企業の意思決定プロセスそのものにエージェントが組み込まれていくことは確実視されていると言えるでしょう。
しかし、足元の2025年を振り返ると、その導入実態はまだ「手探り」の域を出ていません。 私自身、Amazon Bedrock AgentやGoogle ADK、LangChain/LangGraphといった主要なフレームワークを実際に扱っています。 その利用感や日々の調査を通じても、多くの企業にとってAIエージェントは依然としてベストプラクティスが確立されていないフロンティア領域であると感じています。 本稿では、まず、AIエージェントの「学術的背景」を概観することで、AIエージェントの本質の理解を試みます。 その上で、日々の調査やAIエージェントフレームワークを利用して感じた、2025年末時点での技術的な限界と、業務へのAIエージェント適用に関する所感を述べます。
1. 序論:関数近似器としてのLLMと、実務プロセスの乖離
現在、私たちが「AI」と呼んでいる大規模言語モデル(LLM)の本質は、工学的な定義において巨大な関数近似器(Function Approximator)*1と言えます。数理的に見れば、これは入力 X(プロンプト)に対して、学習済みパラメータ θ
に基づいて最も妥当な出力 Y を返す、単なる「写像(Mapping)」です。この構造は、インターネット上の膨大なテキストデータを学習した知識ベースから、必要な情報を引き出す「検索」や「一問一答」のタスクにおいて効果を発揮します。
しかし、私たちエンジニアや研究者が実務で行っている問題解決プロセスは、入力に対して即座に正解が出るような Y=f(X) の単純な関数ではありません。例えば、「数年前に書かれた論文の実装コードを、手元の環境で動かす」 というタスクを想像してください。 READMEの通りに実行して動いてくれれば大変ありがたいですが、ふつうは依存関係の衝突(Dependency Hell)に苦しむでしょう。
このように、普段のタスクは一度の入力で正解は出ず、エラーログという環境からのフィードバックを受け取りながら、仮説と検証を繰り返す試行錯誤のループ(いわゆるPDCAサイクル)構造となります。 ここに、静的な「関数」として設計されたLLMと、動的な「プロセス」を必要とする実務との間の構造上のギャップが存在します。
本稿では、AIを単なる「関数近似器」から、このような試行錯誤を行う「エージェント」へと進化させるための "Reasoning & Acting"(思考と行動) のフレームワークと、その実力を測る "Evaluation"(評価) の現在地を概観します。
2. 思考と行動の技術論:Reasoning & Acting
人間が複雑な問題を解く際、中間的な思考プロセスを経ずにいきなり「答え」が出ることは稀です。 エージェント研究においても、このプロセスをモデル化するためのフレームワークが提案されています。 このフレームワークを理解する上で重要な2つの論文について解説します。
2.1 推論の構造化:Chain-of-Thought (CoT)
Weiらによって提案された "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models" [8] は、現在ではプロンプトエンジニアリングの基礎として定着していますが、その本質は「推論過程の明示化」にあります。
論文中の Figure 1(図1)では、「食堂のリンゴの残り個数」を計算するタスクにおいて、従来手法とCoTの違いが示されています。 以下にその詳細を引用・翻訳します。
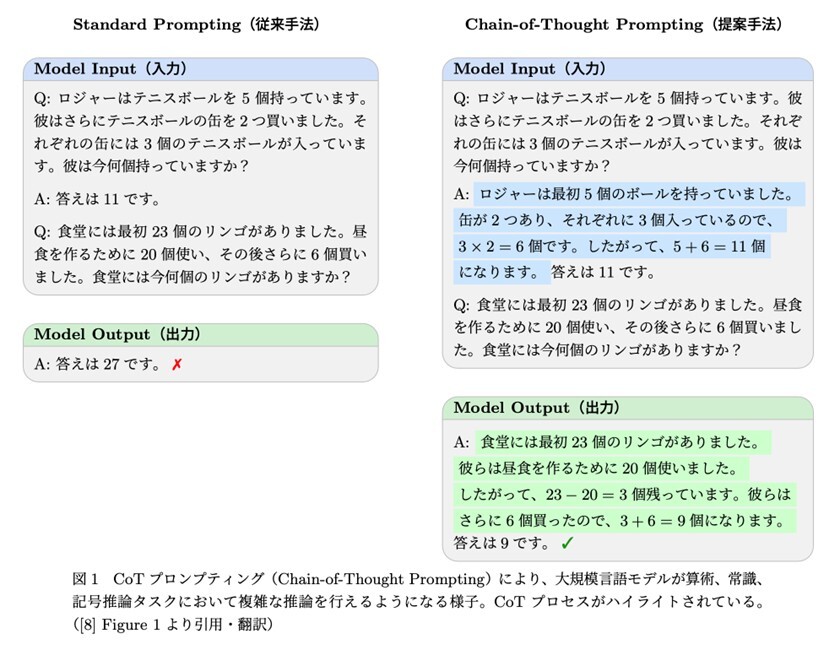
メカニズムの解釈 一見単純に見えますが、これは入力から出力への直接的なジャンプ(Short-cut)を避け、問題を「使用した分を引く」「購入した分を足す」という複数のステップに分解する効果を持ちます。 これにより、複雑な推論を要するタスクにおいても、論理的な整合性を保つことができます。
2.2 思考と行動のループ:ReAct
CoTは推論能力を高めましたが、「モデルが知らない最新情報」や「正確な事実」を必要とする質問には答えられず、もっともらしい嘘(ハルシネーション)をつくことがありました。 そこで、Yaoらによる "ReAct: Synergizing Reasoning and Acting in Language Models" [9] は、CoTに「外部ツールを使う行動(Action)」を組み合わせました。
論文中のFigure 1(図2)の事例を用いて、従来手法(Standard)、推論のみ(CoT)、そして推論と行動(ReAct)の違いを比較してみましょう。
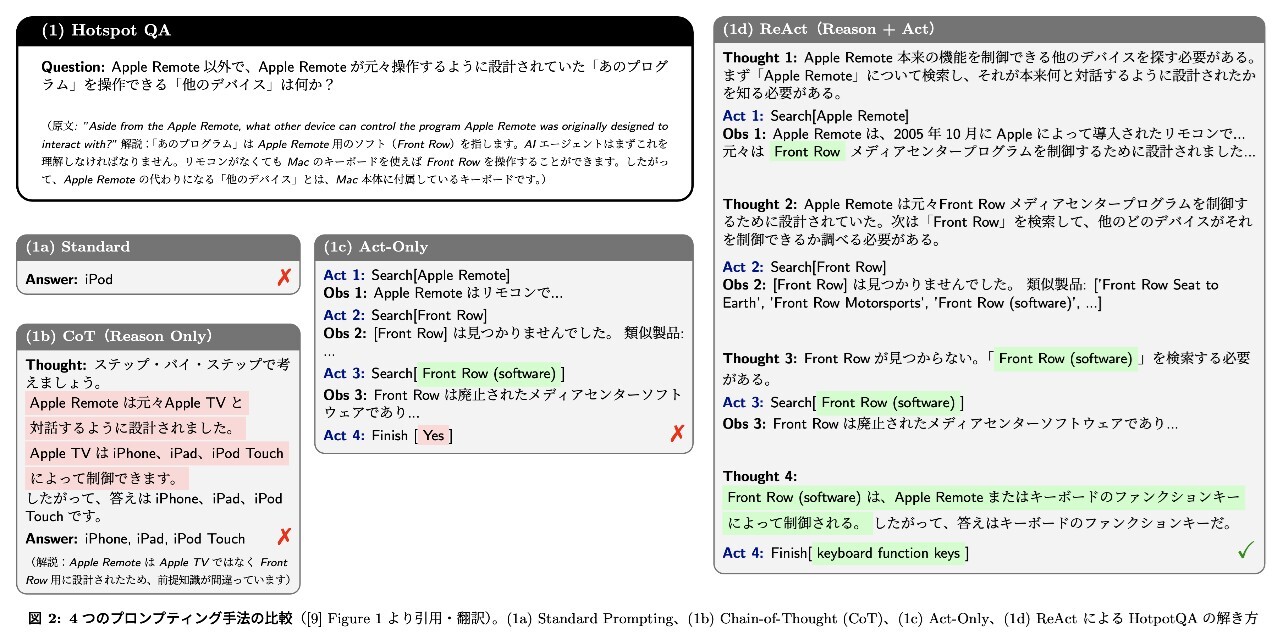
この例から分かるように、CoT単体では「Apple Remote = Apple TV用」という誤った内部知識に基づいて論理を展開していましたが、ReActはObservation(検索結果)という「外部から得られる情報」を推論に取り込むことで、軌道修正を行いながら正解に到達しています。 これが、現在のAIエージェントが「信頼性」を担保するための基本的な構造となっています。
3. ケーススタディ:依存関係の衝突の解消
ここまでの技術(CoTに用いられている「推論過程の明示化」、ReActに用いられている「外部情報の取り込み」)を踏まえ、冒頭の 「数年前に書かれた論文の実装コードを、手元の環境で動かす」 というシナリオに対して、AIエージェントがどのように振る舞うのか考えてみましょう。
以下は、エージェントに「シェル実行(RunShell)」と「Web検索(Search)」のツールを与えた場合の実行ログのシミュレーションです。
エージェントの実行プロセス(ReActの適用)
1. Input: 「このリポジトリの main.py を実行できるようにして。」
2. Round 1
3. Round 2
4. Round 3
5. Round 4(自己修正の発生)
このように、エージェントは静的な知識を一発で出力するのではなく、「行動し(Act)、エラー(Observation)を見て、次の手を考える(Thought)」というループを回すことで、人間が行うデバッグプロセスを再現します。
4. 実環境における評価:Benchmarks
これまで見てきたように、近年のエージェントは複雑な問題設定にたいして、人間のような試行錯誤のループを回すことで解決します。 エージェントの行動の正当性を測定するため、評価手法も「静的なQ&A」から「動的な環境操作」へとシフトしています。
4.1 現実的なWeb操作:WebArena
Zhouらによる "WebArena: A Realistic Web Environment for Building Autonomous Agents" [10] は、Eコマース、GitLab、地図などを模した完全に機能するWeb環境を構築しました。 ここでは評価指標として Functional Correctness(機能的正確性) が採用されており、エージェントの出力テキストではなく、「タスク終了後のデータベースの状態(例:カートの中身)」で成否を判定します。
4.2 ソフトウェアエンジニアリング:SWE-bench
Jimenezらによる "SWE-bench: Can Language Models Resolve Real-World GitHub Issues?" [11] は、scikit-learn や Django といった実際のPythonライブラリの開発コードを管理するGitHubリポジトリ上のIssue (バグ報告・機能追加要望) を解決できるか測るものです。 エージェントはリポジトリ全体を読み込み、修正パッチを作成し、人間が作成したテストコードをパスしなければなりません。 当時の最先端モデル(Claude 2やGPT-4)であっても解決率(Pass@1*2)は低く、数万行のコードから該当箇所を特定する Retrieval(検索) 能力と、既存機能を破壊せずに修正を行う論理的整合性が同時に求められることが大きな障壁となりました。なお、2025年12月の最新モデルにおけるSWE-bench Verifiedの精度は、GPT-5.2: Thinking 80.0%、Gemini 3 Pro: 76.2%、Claude Opus 4.5: 80.9% となっています。
5. 企業視点での評価と実装の課題
最後に、AIエージェントを社会実装する上で避けて通れない「コスト」と「安全性」の議論を紹介します。
5.1 コストとリスクの最適化
Kapoorらによる "AI Agents That Matter" [13] は、既存研究がタスク成功率を追求するあまり、制約付き最適化問題(Constrained Optimization Problem)*3としてのエージェント設計を軽視していると指摘しています。
ケーススタディのRound 4以降で見たように、エージェントは解決策が見つかるまでAPI(Action)を叩き続ける可能性があります。 数十回、数百回と検索とインストールを繰り返せば、クラウドコストや実行時間は無視できないものになります。 実際、現在のAIエージェントフレームワークで簡単な思考フローを実装していても、プロンプトやToolとなる関数のDocstringの書き方によっては、ループに陥ってしまうことも多々ありました。
5.2 AIエージェントの業務への適用についての検討
※筆者個人の見解です。リファレンスに裏付けられるものではありません。
前述の通り、2025年は企業がAIエージェントの導入を検討する事例が多くありました。 ここでは、学術的な評価とビジネスをつなげるために、企業におけるエージェント導入の価値を以下のコスト関数によるモデルで考えてみます。
ソフトウェア開発にコード生成AIエージェントを導入する例において、以下のような式を考えます。
Value=Chuman-(Cagent+Csupervision)
当然ですが、AIエージェント(Cagent ) + エンジニア(Csupervision ) のコストが、エンジニアのみで開発するコストChuman を下回らなければAIエージェントを導入する効果がありません。
LLM自体の精度向上に加え、今回述べたCoT、ReAct等の手法により、AIエージェントは複雑なタスクをこなせるようになってきています。 すなわち、Csupervision はLLMが登場した当初と比べると低下してきていると言えるでしょう。 また、AIエージェント関連技術(実装フレームワーク、プロバイダの機能整備、AIエディタの提供等)の急速な進歩により、AIエージェントの実行コスト(Cagent )は低下しています。
しかし、[13] や [11] の研究が示す通り、AIエージェントが誤りを犯すリスク(誤ったロジックの混入・セキュリティ脆弱性等)は依然として存在します。
最新のテクニカルレポート "DORA 2025 State of AI-assisted Software Development Report" [14] によると、AIが生成したコードに対して「ほとんど、あるいは全く信頼していない」と回答している割合は30%程度で、「信頼はするが検証する(Trust but verify)」という方針で利用することが一般的のようです。 また、AIを活用することによりソフトウェアデリバリーのスループットは向上したものの、不安定性(Instability)は増加したことが取り上げられています。 開発組織がAIに適応できていない場合、AIによって大量のコードが高速に生成されても、それを検証し、安全にリリースするためのプロセス(下流工程)がボトルネックとなり、デリバリーが不安定となります。
したがって、「人間がAIエージェントを監督するコスト(Csupervision )をさらに低減できるしくみを整備し、いかにValue を最大化させられるか」が、今後のAIエージェント導入における関心事になると考えられます。
6. 結論
本稿では、関数近似器としてのLLMが、CoTやReActといったフレームワークを通じて、いかにして「思考」と「行動」のループを獲得したかを見てきました。
皆さまが普段生成AIを活用して感じられている通り、私たちが普段こなしているようなタスクをAIエージェントが完全に自律的に実施する日は近づいていると言えるのではないでしょうか。 しかし、LLMの精度がどれだけ向上しようと、原理上、AIエージェントのミスをゼロにすることはできません。AIエージェントを業務に組み込むためには、単にLLMの性能向上を待つだけでなく、「AIエージェントの仕事の正しさ」を評価する仕組みづくりと、コスト・安全性を含めた総合的なアーキテクチャ設計が必要となるでしょう。
参考文献
[1] "Building effective AI agents." https://www.anthropic.com/engineering/building-effective-agents.
[2] A. Gutowska, "What are AI agents?"https://www.ibm.com/think/topics/ai-agents, Jan. 2026.
[3] P. Bg2, "Ep17. Welcome jensen huang | BG2 w/ bill gurley & brad gerstner." Youtube, Oct. 2024.https://youtu.be/bUrCR4jQQg8?si=8mg70SnAiTma1IFd
[4] "数千兆のAI agentsが常時稼働する世界へ。孫正義 特別講演レポート." https://www.softbank.jp/business/content/blog/202507/sbw2025-softbank-son-main-keynote.
[5] "AIエージェント (AI agent)." https://www.nttdata.com/jp/ja/services/generative-ai/ai-agent/.
[6] "Gartner says agentic AI supply exceeds demand, market correction looms." https://www.gartner.com/en/newsroom/press-releases/2025-10-07-gartner-says-agentic-ai-supply-exceeds-demand-market-correction-looms.
[7] ボストンコンサルティンググループ(編), BCGが読む経営の論点2026. 日経BP, 2025.
[8] J. Wei et al., "Chain-of-thought prompting elicits reasoning in large language models," in Proceedings of the 36th international conference on neural information processing systems, in NIPS '22. Red Hook, NY, USA: Curran Associates Inc., 2022.
[9] S. Yao et al., "ReAct: Synergizing reasoning and acting in language models," in International conference on learning representations (ICLR), 2023.
[10] S. Zhou et al., "WebArena: A realistic web environment for building autonomous agents," in International conference on representation learning, 2024. Available: https://openreview.net/forum?id=oKn9c6ytLx
[11] C. E. Jimenez et al., "SWE-bench: Can language models resolve real-world github issues?" in The twelfth international conference on learning representations, 2024. Available: https://openreview.net/forum?id=VTF8yNQM66
[12] G. Mialon, C. Fourrier, T. Wolf, Y. LeCun, and T. Scialom, "GAIA: A benchmark for general AI assistants," in International conference on representation learning, B. Kim, Y. Yue, S. Chaudhuri, K. Fragkiadaki, M. Khan, and Y. Sun, Eds., 2024, pp. 9025-9049. Available: https://proceedings.iclr.cc/paper_files/paper/2024/file/25ae35b5b1738d80f1f03a8713e405ec-Paper-Conference.pdf
[13] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir, and A. Narayanan, "AI agents that matter," arXiv [cs.LG], Jul. 2024.
[14] D. DeBellis et al., "DORA 2025 state of AI-assisted software development report," Google, 2025. Available: https://dora.dev/dora-report-2025/
脚注(用語解説)
*1 関数近似器 (Function Approximator): 入力と出力の関係(関数)を、データから学習して模倣する数学的モデルのこと。ニューラルネットワークはその一種。
*2 解決率 (Pass@1): 生成された1つの解決策がテストを通過する割合。
*3 制約付き最適化問題: コストや安全性などの制約条件を満たしつつ、目的関数(成功率など)を最大化する問題。
関連するプロジェクト
プロジェクト一覧へ
採用情報
採用情報